Da Turing a Prolog: i linguaggi come forme del pensiero
Da un segnale elettrico a un processo in esecuzione: viaggio dentro la memoria, i limiti della logica e la visione del mondo nascosta dietro il codice.
 Carlo Denza
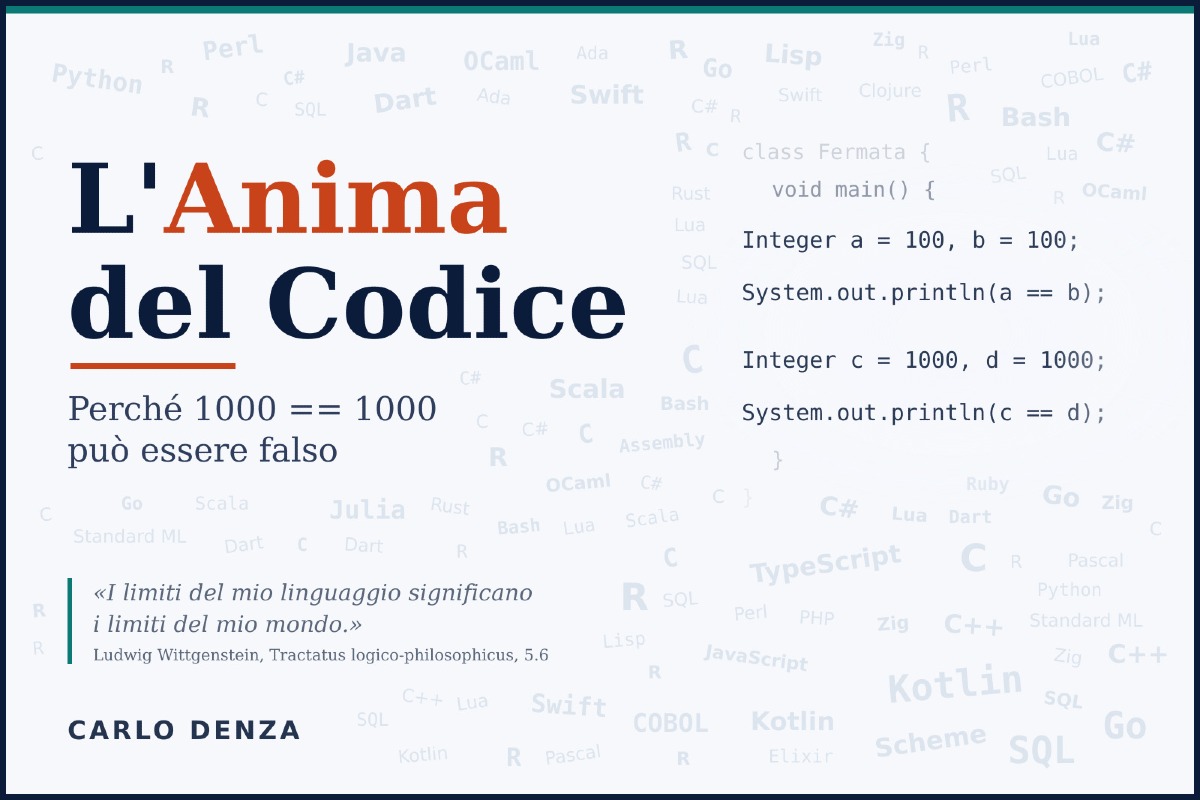
Quel mezzo secondo che trascorre tra la pressione del tasto invio e il momento in cui succede qualcosa sembra niente. Ma a escursione terminata, da qualche parte, tra piste e integrati di silicio, un segnale elettrico inizia il proprio viaggio. Il mio vecchio professore di algebra alla Federico II ci ripeteva: gli informatici sono innanzitutto esperti di linguaggi. Era così preparato che lo chiamavamo “il Signore degli Anelli”, e non gli anelli di Tolkien, ma quelle strutture algebriche che c’insegnava e che usano anche gli informatici. Io invece li ho sempre considerati stregoni moderni, gente che evoca routine, scrive “rituali esoterici” su pezzi di silicio utilizzando grammatiche formali che alla fine decidono com’è fatta la nostra giornata. A me piacciono entrambe le definizioni.
Se dovessi dire quali sono i problemi a cui va incontro chi scrive codice, ne citerei almeno due: il primo è un limite matematico per cui nessun programma si può blindare contro ogni svista. Il secondo è la pulizia della memoria, un lavoro sporco che nessuno vede e senza il quale i programmi si bloccherebbero. Per quello che ho studiato, i linguaggi di programmazione possono essere visti come una maniera per dare un ordine ai problemi del mondo reale che si vogliono risolvere, e liquidarli come semplici sequenze di istruzioni per i circuiti credo sia riduttivo. Allo stesso modo in cui chi parla tedesco e chi parla italiano non descrivono il mondo nello stesso ordine, e le parole con cui etichettiamo le cose influenzano, almeno in parte, quelle che finiamo per notare, lo stesso vale anche per chi scrive codice. Chi fa un altro mestiere, davanti a un listato, potrebbe capirci poco o nulla, ed è proprio pensando a loro che ho scritto queste poche righe. Sono molti gli articoli e i video su sintassi e semantica dei linguaggi di programmazione, ma pochi quelli che provano a raccontare come nasce un’idea dentro un programma e perché anche i software più blasonati si piantano sul più bello. Queste righe provano a raccontare cosa c'è dietro.
Che cos’è un programma
Un linguaggio di programmazione è una lingua artificiale progettata per farsi capire dalla macchina. Quando la usiamo per tradurre in passi concreti la soluzione di un problema, ossia un algoritmo, otteniamo un programma. Finché resta sul disco è solo un file di testo. Appena viene caricato in RAM e lanciato diventa un processo, cioè qualcosa che esegue istruzioni. Nel parlare comune li chiamiamo entrambi "programma" senza distinzioni.
C’è l’idea diffusa che qualunque cosa si batta su una tastiera in codice sia un linguaggio di programmazione, ma per meritarsi il titolo serve la Turing-completezza, la capacità di esprimere la soluzione di qualsiasi problema calcolabile. Ci rientrano C, Java, Python e JavaScript. Vale anche per Minecraft con i suoi circuiti di redstone e, da quando hanno introdotto la funzione LAMBDA, persino per i fogli di Excel. Mentre HTML e JSON ne restano fuori, perché anche se impaginano una schermata web o spostano dati tra server, non dispongono di una memoria potenzialmente infinita né sanno prendere decisioni su strutture annidate a piacere. Ma da dove viene il criterio di Turing-completezza? È il nome stesso ad indicarcelo, tutto ruota attorno a un dispositivo teorico immaginato da Alan Turing negli anni Trenta.
Una macchina di Turing è un dispositivo teorico più semplice di quanto si possa credere. Funziona in questo modo: un nastro senza fine diviso in caselle e una testina che ci scorre sopra, come le vecchie cassette musicali. La macchina legge un simbolo, ne scrive un altro, si sposta di una casella a destra o a sinistra. A dirle cosa fare c’è una tabella di regole, e basta. Semplice, vero? Eppure, per quanto ne sappiamo, qualunque cosa riesca a calcolare un computer la riesce a calcolare anche lei. Ci mette molto di più, ma ci arriva. In informatica il confine passa sempre da lì: o riesci a simulare una macchina di Turing, oppure no.
Il silicio, però, non sa che farsene di un testo scritto ad alto livello: serve un compilatore che prenda il codice sorgente, lo setacci con analisi lessicale, sintattica e semantica e lo traduca. In molti casi, anziché puntare subito all'hardware reale, lo riduce a un formato intermedio destinato a una macchina astratta (o macchina virtuale), un livello software che si occupa di eseguirlo. Quando studiai la questione per la prima volta mi sembrò quasi un trucco, invece di tradurre per molte architetture reali diverse si traduce per una macchina che non esiste, e poi qualcuno si occupa del resto. Il caso più celebre è il bytecode di Java, che permette allo stesso identico software di girare su macchine diverse, ma il principio ritorna pari pari nella piattaforma .NET di Microsoft o nel ventre di Python e Ruby. L’idea in realtà esisteva prima di Java: già negli anni Settanta circolava nei corsi di semantica formale. Mi è sempre parso un bell’escamotage.
Dove finiscono i dati. Lo "spazzino" della memoria
Anche com’è usata la memoria, che sembra un dettaglio da tecnici, cambia a seconda del linguaggio con cui la si governa. Adesso, immaginiamo la memoria come una lunga fila di scatole etichettate, che nei manuali prendono il nome di Data Object. Ogni scatola risponde a quattro coordinate: la Locazione (l’indirizzo fisico in memoria), il Nome scelto dal programmatore, il Valore che contiene e il suo Tipo di dato. L’operazione che lega tra loro queste voci si chiama binding e può avvenire in due modi: prima del lancio, in fase di compilazione (binding statico), oppure a tempo di esecuzione, mentre il programma gira (binding dinamico). È da qui che dipende la differenza più visibile tra linguaggi come Java e Python: il primo sa già a tempo di compilazione se stai mescolando tipi incompatibili, il secondo lo scopre solo a run-time.
Per tenere in ordine queste scatole il computer usa due spazi di memoria distinti. Il primo è lo Stack, immaginalo come una pila di piatti, nella quale l’ultimo piatto appoggiato è sempre il primo a essere tolto (la regola LIFO). Ad ogni chiamata di funzione il sistema impila un blocco (piatto) temporaneo, il Record di Attivazione, con dentro le variabili locali di quel preciso istante. Appena la funzione termina, il blocco salta via e lo spazio torna libero da sé. È un meccanismo rapidissimo, con un unico difetto: la dimensione dello Stack viene decisa all’avvio. Se una funzione ricorsiva scende troppo in profondità lo riempie tutto, e basta dimenticare la condizione di uscita perché il programma si fermi con un errore di stack overflow. La prima volta che mi capitò non capii nemmeno cosa fosse successo.
Chi, come il sottoscritto, ha scritto codice in C su Windows passando per i vari porting di GCC (MinGW, Cygwin, Dev-C++) si ricorda bene cosa succede quando in memoria salta qualche riferimento. Sul terminale spunta un secco “Segmentation Fault”, spia di un puntatore che parte per la tangente, senza una riga di spiegazione: sai solo che da qualche parte hai toccato un indirizzo che non dovevi toccare, e il resto è una caccia al tesoro. Quando invece andava proprio male il programma si chiudeva in silenzio, senza lasciare traccia.
La seconda zona è l’Heap, dove finiscono gli oggetti più ingombranti o dalla vita lunga, quelli che devono sopravvivere alla funzione che li ha creati. Il punto è che prima o poi quelle scatole inutilizzate qualcuno deve buttarle, eliminarle. Nei linguaggi di vecchia scuola tocca allo sviluppatore farlo a mano (in C con la classica chiamata a free), ed è lì che nascono quasi tutti i memory leak (memoria occupata che nessuno restituisce) e i puntatori pendenti (indirizzi che puntano a scatole già buttate). In linguaggi come Java o Python c’è invece un addetto alle pulizie automatico, il Garbage Collector. Con la gestione manuale controlli ogni singolo byte, ma alla prima distrazione paghi dazio. Il Garbage Collector ti toglie un po’ di controllo, ma ti salva dai pasticci più banali. Se sia un affare o meno, onestamente, dipende dai giorni e dal progetto.
L’algoritmo di pulizia più celebre è il Mark and Sweep, “segna e spazza”. Quando la memoria libera comincia a scarseggiare, parte dalle variabili vive in quel momento (root), segue i riferimenti da un oggetto all’altro e mette un timbro su tutto quello che riesce a raggiungere. Subito dopo scorre l’intero Heap ed elimina ogni scatola rimasta senza timbro, restituendo i byte al sistema. Saltano via anche le isole di oggetti che si puntano tra loro in cerchio, visto che partendo dalle root non c’è più alcuna strada per arrivarci. Il conto da pagare sono le micro-pause, quei brevi momenti in cui l’ambiente di esecuzione deve congelare il programma per fare ordine.