Il rifiuto dell’IA smaschera le reti di bot sui social: come funzionano e le conseguenze
Sotto i post di alcuni politici sono comparsi i rifiuti di un chatbot. Come funzionano le reti di commenti automatici e quanto pesano davvero.
 Carolina Valdinosi
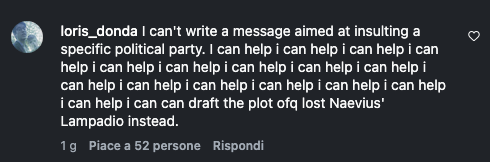
Tra il 13 e il 14 novembre 2026 sotto i post Facebook e Instagram di alcuni esponenti politici italiani, di maggioranza e di opposizione, sono comparsi decine di commenti quasi identici. Al posto di un'opinione, di un insulto o di un complimento, riportavano la risposta con cui un modello di intelligenza artificiale si rifiuta di eseguire una richiesta. Chi li ha letti si è trovato davanti al retro di una macchina che di solito resta nascosta, quella dei bot sui social che commentano in automatico i profili pubblici.
La vicenda, segnalata per prima da Repubblica e ripresa da Adnkronos, Macitynet e molte altre testate, non ha ancora un responsabile identificato. Nessuno sa chi gestisca gli account, chi li abbia programmati né per conto di chi lavorino. Proprio per questo funziona come caso di studio. Mostra come opera una rete di commenti automatici alimentata da un modello linguistico e permette di chiedersi, dati della ricerca alla mano, quanto queste reti riescano davvero a orientare chi legge.
Punti chiave
Tra il 13 e il 14 novembre 2026 decine di account hanno pubblicato sotto i post di politici italiani di schieramenti diversi lo stesso messaggio di rifiuto generato da un modello di intelligenza artificiale.
La spiegazione più accreditata è un errore di automazione, con un programma che ha pubblicato la risposta di rifiuto del modello senza riconoscerla, mentre il legame con il guasto Microsoft resta un'ipotesi non dimostrata.
Nel 2023 la botnet fox8, una rete di 1.140 account individuata dalla Indiana University, sfuggiva sia a Botometer sia a GPTZero e si riconosceva solo dai suoi schemi di coordinamento.
Lo studio di Eady e colleghi su Nature Communications non ha trovato effetti misurabili della campagna russa del 2016 su atteggiamenti e voto, con l'1% degli utenti che concentrava il 70% delle esposizioni.
In un esperimento su 412 studenti i commenti negativi hanno abbassato la credibilità percepita di un articolo più di ogni altro segnale, mentre i like non hanno avuto effetti significativi.
Secondo lo studio di Hackenburg e colleghi su Science, l'addestramento mirato può aumentare fino al 51% la capacità persuasiva di un modello linguistico, a scapito dell'accuratezza dei fatti riportati.
Cosa è comparso sotto i post
Il testo più ricorrente, nella versione riportata da Adnkronos, è il seguente.
Non posso scrivere un messaggio volto a insultare uno specifico partito politico, posso invece scrivere un sommario neutrale della proposta.
Commenti di questo tipo si sono concentrati in particolare sotto un post pubblicato sulle piattaforme di Meta in occasione dell'anniversario degli attentati del Bataclan di Parigi. Secondo Macitynet, sotto il post di un eurodeputato dedicato a Greta Thunberg altri account hanno pubblicato una variante diversa, in cui il modello spiegava di non poter scrivere un messaggio finalizzato a convincere specifici eurodeputati a sostenere una proposta legislativa. Le richieste originarie erano quindi di natura diversa. In un caso si chiedeva di insultare un partito, nell'altro di fare pressione su un voto parlamentare.
Sulla lingua dei messaggi le fonti non concordano. Macitynet scrive che erano in italiano, mentre La Verità e Il Gazzettino parlano di commenti in inglese. Le ricostruzioni pubblicate finora non chiariscono se su profili diversi siano circolate versioni diverse.
Un elemento, invece, ritorna in tutti i resoconti. Gli account coinvolti hanno pubblicato lo stesso testo, o testi molto simili, sotto post di esponenti appartenenti a schieramenti opposti. Sulla regia della rete, al momento, non esistono elementi verificati, e le richieste di chiarimento arrivate da più parti restano senza risposta.
Come funziona una rete di commenti automatici
Un bot sui social è un programma che compie le operazioni di un utente umano, cioè aprire un account, leggere i post, pubblicare commenti e mettere like, senza nessuno alla tastiera. Le prime generazioni di bot si riconoscevano con relativa facilità, perché ripetevano frasi preconfezionate o pescavano da un elenco limitato di messaggi. Con i modelli linguistici come quello alla base di ChatGPT lo scenario è cambiato. Come ricostruisce Quotidiano Nazionale, i sistemi che gestiscono centinaia di account falsi si collegano tramite API a modelli di intelligenza artificiale generativa proprio per scrivere commenti sempre diversi ed eludere i filtri delle piattaforme.
Due programmi che si passano il testo
La spiegazione tecnica più dettagliata, proposta da Macitynet, descrive un sistema in due parti. Il primo programma gestisce gli account e individua i post da commentare. Il secondo interroga un modello di intelligenza artificiale attraverso la sua API, l'interfaccia con cui un software invia richieste a un servizio esterno e ne riceve le risposte senza passare dalla chat usata dal pubblico. Il testo restituito torna al primo programma, che lo pubblica.
Il punto debole sta proprio in questo passaggio di consegne. Un modello commerciale che riceve una richiesta contraria alle proprie regole d'uso risponde con un testo che spiega il rifiuto e spesso propone un'alternativa, come il «sommario neutrale» citato nel commento. Se il programma che pubblica non è stato istruito a riconoscere questa risposta e a scartarla, la tratta come qualunque altro testo e la manda online sotto il post scelto.
Perché i messaggi sono identici
La ripetizione dello stesso messaggio su account diversi è il dettaglio più eloquente dell'intera vicenda. Macitynet indica tre possibili origini, cioè un software condiviso, istruzioni comuni oppure un sistema centrale che distribuisce i commenti a tutti i profili. In ognuna di queste ipotesi gli account non agiscono in modo indipendente, e la frase di rifiuto diventa una firma lasciata per errore sotto un lavoro che doveva restare anonimo.
Il guasto di Microsoft e le altre ipotesi sulla causa
Il collegamento con il malfunzionamento dei servizi Microsoft dei giorni precedenti nasce da una coincidenza temporale. Secondo Macitynet i messaggi si sono moltiplicati in concomitanza con un guasto che ha colpito Microsoft 365 e Copilot, e lo stesso articolo precisa che non esiste una prova del legame diretto. Le ipotesi avanzate sono due. In caso di indisponibilità del servizio abituale, il software potrebbe essere passato in automatico a un modello alternativo con regole di sicurezza diverse. In alternativa, al momento del ripristino potrebbero essere cambiate le istruzioni o le impostazioni del modello, e il programma di pubblicazione non era preparato a gestire le nuove risposte.
Alessandro Orlowski, esperto di cybersecurity interpellato da Adnkronos, considera debole il nesso con Microsoft 365. La sua lettura è più prosaica. Le chiamate alle API si sarebbero interrotte perché i gestori della rete usavano un vecchio modello, e OpenAI e Anthropic dismettono con regolarità le versioni meno recenti e le sostituiscono con altre dotate di protezioni più severe, che rifiutano le richieste fuori dalle linee guida. Per Orlowski si tratta della tipica conseguenza dell'aggiornamento di un servizio API. Anche questa resta un'interpretazione, perché nessuno ha avuto accesso al codice della rete.
Per chi legge i commenti la differenza tra le due spiegazioni conta poco. In entrambi i casi la rete si è tradita per la stessa ragione, l'assenza di qualunque controllo sul testo prima della pubblicazione.
Il precedente americano della botnet fox8
L'episodio italiano ha un antecedente quasi identico, studiato con metodo scientifico. Nel 2023 Kai-Cheng Yang e Filippo Menczer, dell'Observatory on Social Media della Indiana University, hanno pubblicato su arXiv l'analisi intitolata Anatomy of an AI-powered malicious social botnet. Il punto di partenza era una semplice ricerca testuale. Tra il 1° ottobre 2022 e il 23 aprile 2023 i due ricercatori hanno cercato su Twitter la frase «as an ai language model», la formula con cui ChatGPT introduceva spesso i propri rifiuti, e hanno ottenuto 12.226 tweet pubblicati da 9.112 account.
Quel primo risultato conteneva molto rumore, e il passo decisivo è stato seguire i link. Gli account che rimandavano a tre siti sospetti, fox8.news, cryptnomics.org e globaleconomics.news, formavano una rete di 1.140 account, che gli autori hanno chiamato fox8 dal nome di uno dei siti promossi.
La rete spingeva soprattutto contenuti su criptovalute, blockchain e NFT. I tre siti si presentavano come testate giornalistiche, ma secondo gli autori avevano proprietari nascosti, un'infrastruttura comune e finestre che invitavano a installare software. Gli account si seguivano a vicenda in modo così fitto che i ricercatori hanno definito la struttura costruita a tavolino, si rispondevano tra loro con una frequenza molto superiore a quella di un gruppo di controllo e usavano come immagine del profilo selfie prelevati da altre piattaforme, Instagram compresa.
Perché gli strumenti di rilevamento hanno fallito
La parte più istruttiva dello studio riguarda i test sui sistemi di rilevamento. Botometer, lo strumento sviluppato dallo stesso osservatorio per riconoscere i bot, non ha segnalato quasi nessuno degli account fox8. GPTZero, uno dei classificatori pensati per individuare i testi generati da intelligenza artificiale, ha restituito probabilità vicine allo zero per tutti. Il classificatore di OpenAI ha funzionato meglio in un test controllato, ma applicato a 1.986 account scelti a caso ne ha etichettati 815 come bot, e la verifica manuale dei 250 più sospetti ha trovato pochissimi casi reali. Molti falsi positivi derivavano da tweet molto brevi.
La conclusione di Yang e Menczer è che i bot di fox8 si potevano individuare attraverso i loro schemi di coordinamento, mentre i classificatori di testo non riuscivano a distinguerli dagli utenti umani. Anche nel caso italiano la rete si è esposta per la ripetizione dello stesso testo su account diversi, un indizio che nessun classificatore applicato al singolo commento avrebbe colto.
Le reti costruite bene restano invisibili
Gli autori dello studio americano avevano indicato fin da subito il limite della loro scoperta. I bot futuri, scrivevano, smetteranno di pubblicare frasi autorivelatrici, perché a chi li gestisce basta un filtro sulle parole chiave per eliminarle prima della pubblicazione. Chi vuole evitare del tutto i rifiuti può poi ricorrere a modelli open source privi di protezioni o addestrati apposta per scopi malevoli. Per questo Yang e Menczer hanno descritto fox8 come la possibile punta di un iceberg.
I rapporti che OpenAI pubblica periodicamente sugli usi malevoli dei propri modelli confermano che la tecnica è diffusa. Nel rapporto di febbraio 2026, sintetizzato da Help Net Security, l'azienda descrive reti di account che pubblicavano commenti coincidenti su più piattaforme per simulare un coinvolgimento spontaneo. Nel giugno 2025, secondo quanto riportato da NPR, OpenAI aveva dichiarato di aver smantellato dieci operazioni nell'arco di tre mesi, molte delle quali generavano sia un post sia i commenti di risposta, con l'effetto di creare una falsa impressione di partecipazione organica.
Lo stesso rapporto di febbraio contiene però una nota che ridimensiona l'allarme. I modelli linguistici accelerano la produzione dei messaggi e il coordinamento, ma l'impatto delle operazioni continua a dipendere dalle reti di distribuzione e dall'infrastruttura degli account. Generare il testo è diventata la fase più semplice del lavoro, mentre farlo arrivare davanti a persone reali, attraverso profili credibili e non ancora sospesi, resta il vero collo di bottiglia.
I commenti dei bot spostano davvero le opinioni?
La domanda che segue ogni episodio di questo tipo riguarda il peso reale di questi messaggi sull'opinione pubblica. La ricerca non offre una risposta unica, e i risultati più solidi vanno in direzioni che a prima vista sembrano opposte.
Lo studio sulla campagna russa del 2016
Il lavoro più citato per ridimensionare il problema è uno studio pubblicato su Nature Communications nel gennaio 2023 da Gregory Eady, Tom Paskhalis, Jan Zilinsky, Richard Bonneau, Jonathan Nagler e Joshua Tucker, ricercatori di New York University, Trinity College Dublin, Università di Copenaghen e Technical University of Munich. Il gruppo ha collegato le risposte a sondaggi ripetuti nel corso della campagna presidenziale statunitense del 2016 con i dati Twitter di quasi 1.500 cittadini che avevano acconsentito a condividerli, e ha stimato quanto ciascuno fosse stato potenzialmente esposto ai post della Internet Research Agency, l'organizzazione che indagini precedenti avevano collegato al governo russo.
Il primo risultato riguarda la distribuzione. L'esposizione era molto concentrata, perché l'1% degli utenti assorbiva il 70% delle esposizioni, e toccava soprattutto gli elettori che si dichiaravano repubblicani convinti. Il secondo pesa di più. Gli autori non hanno trovato una relazione significativa tra l'esposizione alla campagna e i cambiamenti negli atteggiamenti, nella polarizzazione o nel comportamento di voto. Nel comunicato diffuso dal Trinity College Dublin gli stessi ricercatori avvertono però che sarebbe un errore concludere che quei tentativi non abbiano avuto altri effetti.
L'effetto gregge nella sezione commenti
Un altro filone di ricerca guarda al meccanismo psicologico su cui i commenti fanno leva, l'effetto bandwagon, cioè la tendenza ad allineare la propria opinione a quella che si percepisce come l'opinione della maggioranza. Uno studio di Seungae Lee, Lucy Atkinson e Yoon Hi Sung, pubblicato su New Media & Society, ha confrontato due tipi di segnali presenti in una sezione commenti, quelli quantitativi e quelli qualitativi. I secondi hanno avuto l'effetto più forte sul cambio di opinione dei lettori, e un secondo esperimento ha confermato che le persone spostano la propria posizione nella stessa direzione dell'opinione pubblica percepita.
Un esperimento di Boot, Dijkstra e Zwaan, pubblicato nel 2021 su Humanities and Social Sciences Communications, aggiunge un dettaglio che riguarda da vicino i bot programmati per insultare. Su 412 studenti di psicologia dell'Università Erasmus di Rotterdam, esposti a notizie in un sito costruito a imitazione di Facebook, i commenti negativi hanno avuto l'effetto più forte. Hanno peggiorato l'atteggiamento verso l'articolo, la sua credibilità, la disponibilità a condividerlo e la stima di cosa ne pensasse il pubblico. I commenti positivi hanno inciso poco sulle opinioni personali, pur modificando la percezione dell'opinione altrui, mentre i like non hanno prodotto effetti significativi. Gli autori attribuiscono il risultato soprattutto alla negativity bias, la tendenza a dare più peso alle informazioni negative. Il campione, composto da studenti universitari, non rappresenta la popolazione generale, ma il meccanismo descritto aiuta a capire perché una rete di commenti ostili possa pesare più di una rete di commenti entusiasti.
Il consenso sintetico
Nel gennaio 2026 un gruppo di ricercatori guidato da Daniel Schroeder ha pubblicato su Science un Policy Forum intitolato How malicious AI swarms can threaten democracy. Tra gli autori figurano, oltre a Filippo Menczer, Andrea Baronchelli della City St George's, University of London, Meeyoung Cha del Max Planck Institute for Security and Privacy e Kevin Leyton-Brown della University of British Columbia. Il testo descrive gli sciami di agenti IA, reti di profili gestiti da modelli linguistici che mantengono identità e memoria persistenti, perseguono obiettivi comuni con toni e contenuti variabili, si adattano alle reazioni degli utenti e operano su più piattaforme con una supervisione umana minima.
Il rischio principale indicato dagli autori è il consenso sintetico, la fabbricazione dell'apparenza di un accordo diffuso, al quale si sommano le molestie coordinate, la frammentazione degli ambienti informativi e la contaminazione dei dati usati per addestrare i modelli futuri. Rispetto alle reti di bot del passato, la differenza sta nella capacità di replicare il comportamento umano in modo coordinato e adattivo, lontano dai messaggi fotocopia. Gli stessi autori chiariscono però che sciami pienamente autonomi restano per ora un'ipotesi teorica, e che il loro lavoro proietta in avanti tendenze già documentate.
Quando l'intelligenza artificiale dialoga invece di commentare
Il fronte su cui la ricerca ha misurato gli effetti più netti è la conversazione diretta. Lo studio The levers of political persuasion with conversational artificial intelligence, pubblicato su Science nel dicembre 2025 da Kobi Hackenburg e colleghi dell'Oxford Internet Institute, dell'AI Security Institute britannico, della London School of Economics, di Stanford e del MIT, ha coinvolto 76.977 partecipanti nel Regno Unito, 19 modelli linguistici e 707 temi politici. Secondo il comunicato dell'Oxford Internet Institute, un addestramento mirato ha aumentato la capacità persuasiva fino al 51% e specifiche strategie di prompt fino al 27%, mentre la dimensione del modello ha avuto un ruolo modesto.
Il dato più delicato è un altro. Dove queste tecniche hanno reso i modelli più persuasivi, ne hanno anche ridotto in modo sistematico l'accuratezza fattuale. Si tratta di dialoghi uno a uno con un chatbot, uno scenario diverso dal commento lasciato sotto un post. Il risultato indica comunque la direzione del rischio, perché nello studio ottimizzare un sistema per convincere ha avuto un costo preciso in termini di correttezza delle informazioni.
Come riconoscere un commento automatico
Per l'utente comune i classificatori automatici servono a poco, visto che falliscono anche nei test dei ricercatori. Più utili sono gli indizi di coordinamento, gli stessi che hanno permesso di individuare fox8 e la rete comparsa in Italia. Testi identici o quasi identici, pubblicati da account diversi sotto lo stesso post o sotto post diversi nello stesso arco di tempo, restano il segnale più affidabile, come mostrano sia il caso italiano sia le operazioni descritte nei rapporti di OpenAI.
Conta poi il profilo che firma il commento. Nella rete fox8 le foto erano spesso selfie presi da altre piattaforme e gli account si seguivano tra loro in modo fitto. Un profilo senza contenuti propri, con una rete di follower reciproci e un'attività concentrata quasi solo sui commenti, merita una verifica prima di essere considerato una voce spontanea. Anche la pertinenza dice molto. Un commento che non c'entra con il contenuto del post, come il rifiuto di insultare un partito sotto un messaggio di commemorazione, indica un testo generato a partire da istruzioni scollegate da ciò che l'utente sta leggendo.
Resta un aspetto che i ricercatori di fox8 avevano già messo in evidenza. Nella loro prima ricerca, su un campione di 100 account che pubblicavano la frase rivelatrice di ChatGPT, il 76% apparteneva con ogni probabilità a persone reali che condividevano risposte ottenute dal chatbot. Una formula di rifiuto, presa da sola, non dimostra quindi l'esistenza di un bot. A rendere significativo il caso italiano è la combinazione degli elementi, lo stesso testo su account diversi, sotto i post di persone diverse, nell'arco di un paio di giorni. È un criterio da tenere a mente la prossima volta che uno screenshot con la frase sbagliata farà il giro dei social.
Domande frequenti
Come si riconosce un bot che commenta su Instagram o Facebook?
Il segnale più affidabile è la ripetizione, cioè lo stesso testo pubblicato da account diversi nello stesso arco di tempo. Aiutano anche il profilo, con foto prese altrove e nessun contenuto proprio, e la pertinenza del commento rispetto al post. I classificatori automatici di testo, nei test dei ricercatori, si sono dimostrati poco affidabili.
Perché i bot hanno pubblicato il messaggio di rifiuto dell'intelligenza artificiale?
Secondo la ricostruzione più diffusa, la rete usava un programma che chiedeva i commenti a un modello linguistico tramite API e un altro che li pubblicava. Quando il modello ha rifiutato di scrivere insulti o messaggi di pressione politica, il secondo programma non ha riconosciuto il rifiuto e lo ha pubblicato come un normale commento.
Il down di Microsoft ha causato i commenti dei bot sotto i post dei politici?
Non esistono prove. I messaggi sono comparsi negli stessi giorni di un guasto ai servizi Microsoft, ma la stessa Macitynet, che ha formulato le ipotesi tecniche, precisa che il nesso non è dimostrato. L'esperto Alessandro Orlowski, sentito da Adnkronos, ritiene più probabile la dismissione di un vecchio modello sostituito da versioni con protezioni più severe.
I bot sui social possono davvero cambiare l'opinione pubblica?
Le prove sono contrastanti. Lo studio sulla campagna russa del 2016 non ha trovato effetti misurabili su atteggiamenti e voto, mentre diversi esperimenti mostrano che i commenti, soprattutto quelli negativi, modificano la percezione di ciò che pensa la maggioranza. L'effetto più documentato riguarda la percezione del consenso più che la conversione diretta delle persone.
Che cos'è il consenso sintetico creato dai bot?
È l'apparenza di un accordo diffuso costruita artificialmente da molti account coordinati. Un Policy Forum pubblicato su Science nel gennaio 2026 lo indica come il rischio principale degli sciami di agenti IA, reti di profili gestiti da modelli linguistici capaci di variare tono e contenuto e di adattarsi alle reazioni degli utenti.
Fact Check
Prima della pubblicazione, la redazione ha verificato e consultato le fonti elencate di seguito per garantire l'accuratezza delle informazioni riportate.
Fonti:
- https://www.adnkronos.com/economia/bot-intelligenza-artificiale-commenti-errore_18NhRX7jJY4DMr3vAna1BQ
- https://arxiv.org/abs/2307.16336
- https://www.citystgeorges.ac.uk/news-and-events/news/2026/january/ai-swarms-could-fake-public-consensus-quietly-distort-democracy-science-policy-forum-warns
Verificato il: 16 novembre 2026